Antrenarea AI distribuită: recuperare automată la defecțiuni
De ce defecțiunile se multiplică Antrenarea la scară mare rulează pe zeci de mașini. Defecțiunile de hardware și erorile de software întrerup progresul. Tim-out-urile din biblioteca de comunicații…
De ce defecțiunile se multiplică
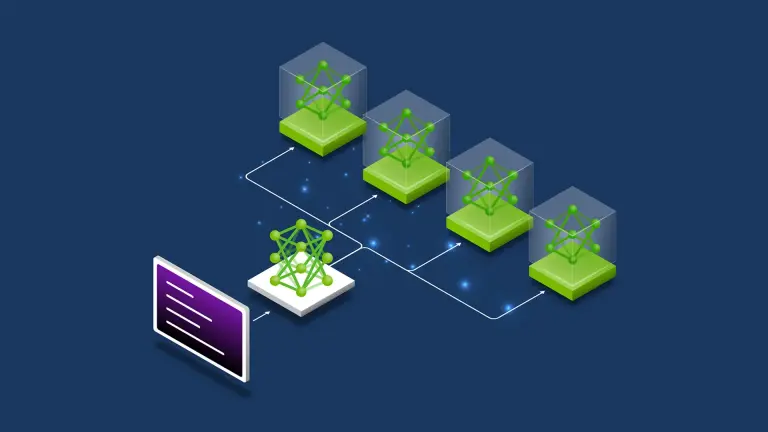
Antrenarea la scară mare rulează pe zeci de mașini. Defecțiunile de hardware și erorile de software întrerup progresul. Tim-out-urile din biblioteca de comunicații NVIDIA și nodurile GPU care nu răspund opresc tot job-ul.
Sistemul detectează defecțiunile în timp real. Repornește automat rank-urile afectate. Asta ține pipeline-ul de antrenare în mișcare, fără intervenție manuală.
Pe măsură ce cluster-ul crește, probabilitatea de defecțiune a unui component crește brusc. Un singur nod mort poate opri tot job-ul. Nodurile care întârzie încetinesc toți ceilalți participanți. Rezultatul e compute irosit și livrarea modelului întârzie.
Putem elimina complet intervenția manuală?
Mecanismul de recuperare izolează componenta defecțiune. Înlocuiește-o cu una sănătoasă. Antrenarea se reia din ultimul checkpoint. Asta reduce timpul de inactivitate de la minute la secunde.
Da, pentru majoritatea modurilor de defecțiune. Sistemul gestionează automat tim-out-urile NCCL, nodurile morți și nodurile care întârzie. Operatorii intervin doar pentru probleme rare și complexe.
Abordarea reduce drastic timpul mediu de recuperare. Echipele pot rula cluster-uri mai mari cu încredere. Randamentul antrenării crește pentru că timpul de așteptare scade.
Întrebări frecvente
Funcționează pentru orice framework distribuit? Logicul de recuperare e agnostic față de framework. Monitorizează sănătatea job-ului la nivel de scheduler. Repornește rank-urile defecțiune indiferent de biblioteca de antrenare folosită.
Cât de des apar defecțiunile în cluster-urile mari? În cluster-uri cu mii de GPU-uri, o defecțiune apare la câteva ore. Recuperarea automată transformă asta din criză într-un non-eveniment.
Ce date sunt necesare pentru a relua antrenarea? Sistemul se bazează pe checkpoint-uri periodice. Ultima stare salvată devine punctul de reluare. Nu se pierde date decât în intervalul dintre checkpoint-uri.
Sursă: Nvidia
Mai multe din Cipuri
- Cyclon transformă vechile Google Pixel în asistente AI all-in-one
- Inteligența artificială în marketing: cum se schimbă producția de conținut video
- Anthropic cheltuiește 1,7 miliarde dolari pe salarii într-un singur trimestru
- Revoluție în AI: Modelele care învață să se optimizeze singure
- Proprietarii de site-uri primesc „arme” noi împotriva roboților AI: Cum poți bloca colectarea datelor
- Apple aduce inteligența artificială audio pe smartwatch-uri!
Discuții
Nicio intervenție încă. Deschide discuția cu prima ta observație.